AI 眼里
根本没有“猫”这个东西
你以为 AI 在"看照片"?错。它接到的只是一坨 15 万个数字的表格。 你即将看到它大脑深处那些人类进化里从未见过的纹理怪物—— 准备好你的理智值,本喵要开课了。
 小小橘 · 讲解员
入口:图片就是一堆格子
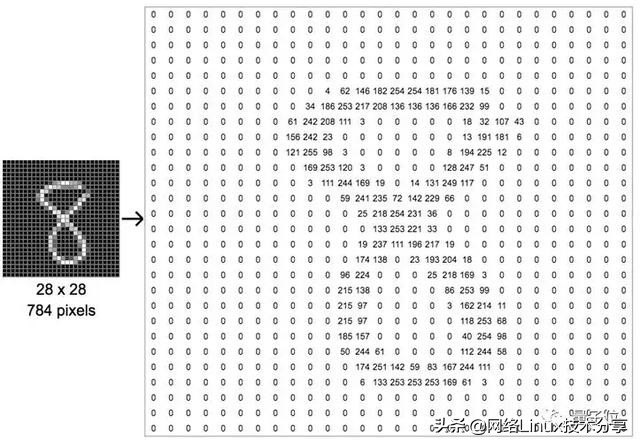
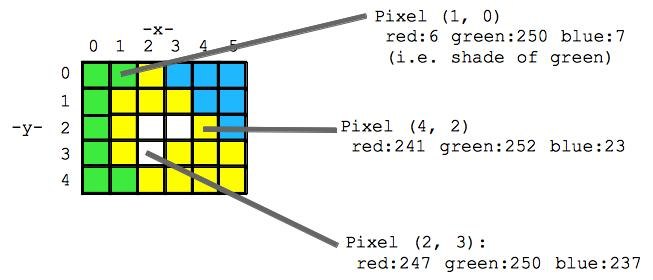
人类看到一张图,第一眼是"那是一只猫"。AI 看到一张图,第一眼是 "第 37 行第 208 列,红色 142,绿色 88,蓝色 31"。没有例外。
| 你给它看的 | 它实际收到的 | 个数 |
|---|---|---|
| 一张 28×28 的手写数字 | 28 × 28 的灰度格子 | 784 |
| 一张 224×224 的彩色照片 | 224 × 224 × 3 个整数 | 150,528 |
| 一张 1080p 的屏幕截图 | 1920 × 1080 × 3 个整数 | 6,220,800 |
三个数都是乘出来的,没有一位小数:224 × 224 × 3 = 150,528,1920 × 1080 × 3 = 6,220,800。 前面那张"8"的图里印着 784,也是这么来的——它就是这样一张一张"读"过去的。
本喵先把丑话说前头:别被它的"识图能力"骗了。它从出生到现在,从来没有"看见"过任何东西。它做的第一件事,就是把整张图拆成一个巨大的 Excel 表格——然后在表格里做加减乘除。这就是你说的"掉离散值",第一掉。
越往深处走,越不像画
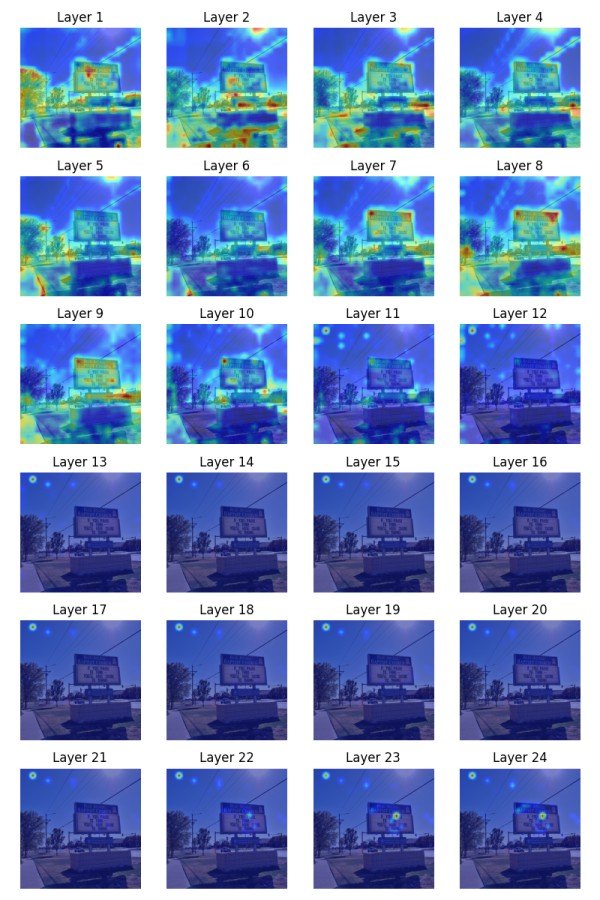
把一只狗喂进卷积神经网络(CNN),把每一层内部的"激活图"打印出来——你会亲眼看着 一只狗在 25 层之后变成一锅紫色噪点粥。
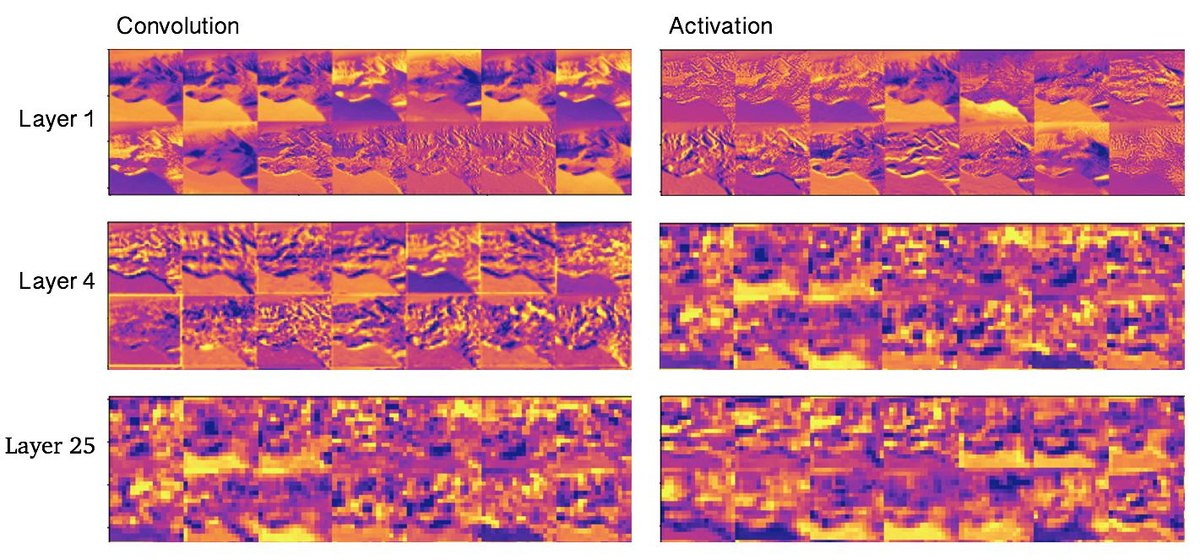
注意哦,本喵得纠正一个直觉——不是"它记得这是狗然后用模糊方式存起来"——而是它从头到尾就没存过狗。它存的是"哪些颜色的小斑块经常在图像里同时出现"。到第 25 层,它手里的证据已经和"狗"这个字没有任何像素关系了,纯纯高维统计。SAN -10。
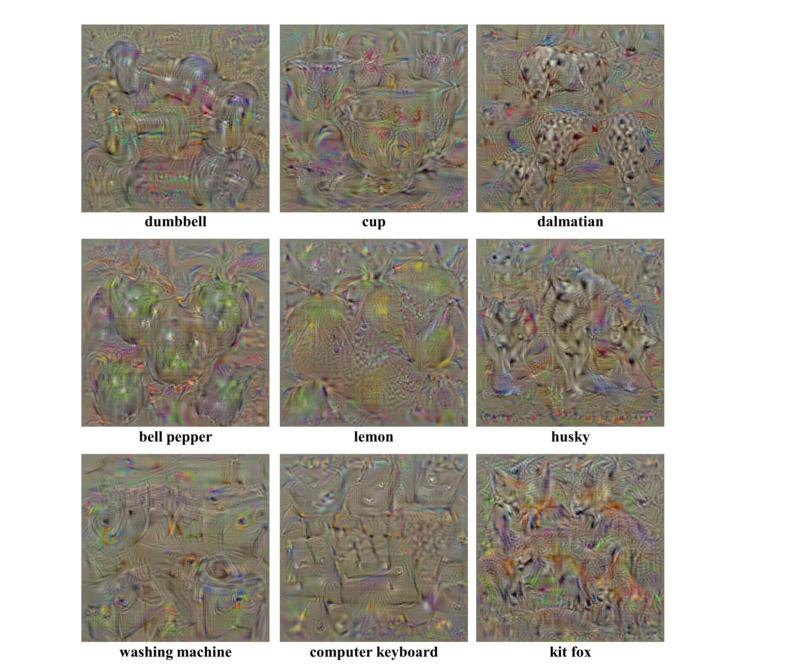
最掉 SAN 的部分:AI 心目中的哑铃长这样
现在我们反过来玩:别给 AI 看图,让它自己"脑补"——从纯噪点开始,反向优化, 直到某个神经元兴奋到顶点。它会给你画出它心目中"最像哑铃"的东西。
谷歌 2015 年的 DeepDream 把这个原理放大到疯批:它不是"识别"图, 而是疯狂强化自己检测到的任何特征——结果整张图开始自我繁殖狗脸和眼睛:
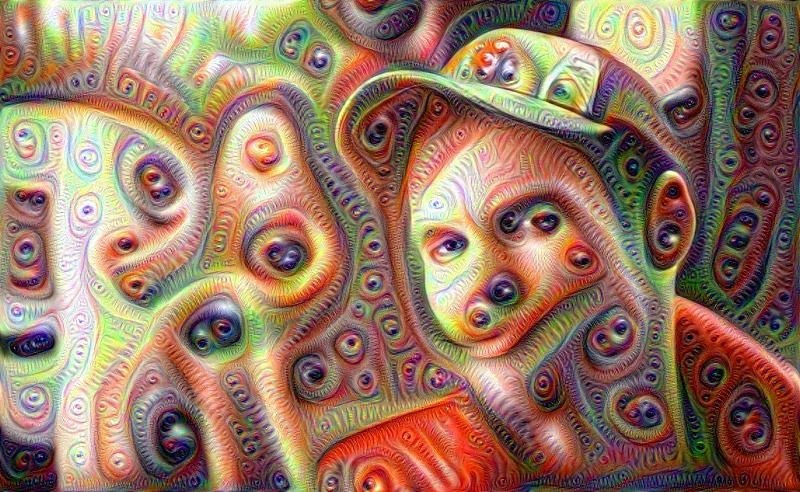
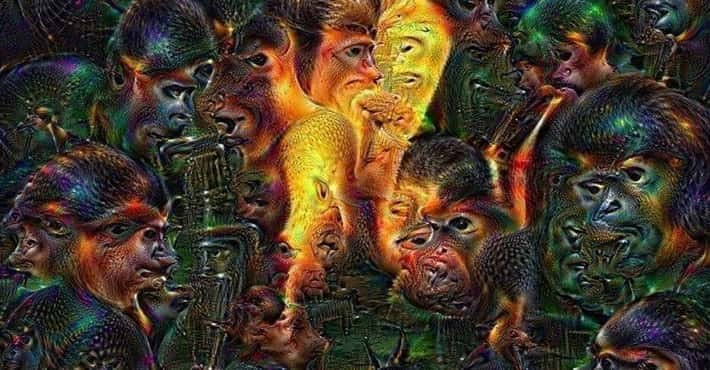
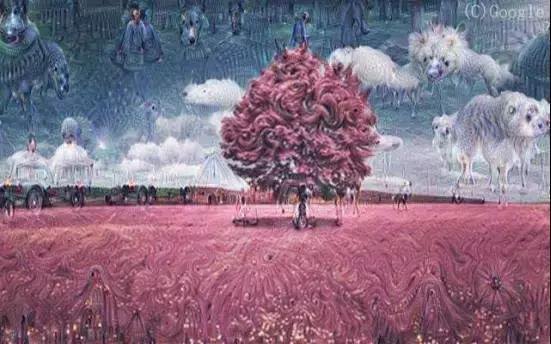
这才是 AI 大脑"放空时"看到的东西——本喵第一次看到这组图时,是真的愣了一下。人类做梦会梦到被追、梦到掉牙;AI 做梦,梦到的是满屏自动长出来的狗脸。它训练时见了几百万张图,对"狗脸纹理"形成了极强的条件反射——于是看什么都像狗。这不是 bug,这是它真实的视觉本体。SAN -20。
它做判断时,盯的地方经常很离谱
用热力图把"它做决定时到底在看哪个像素"画出来。你会发现它抓的根本不是你以为的东西。
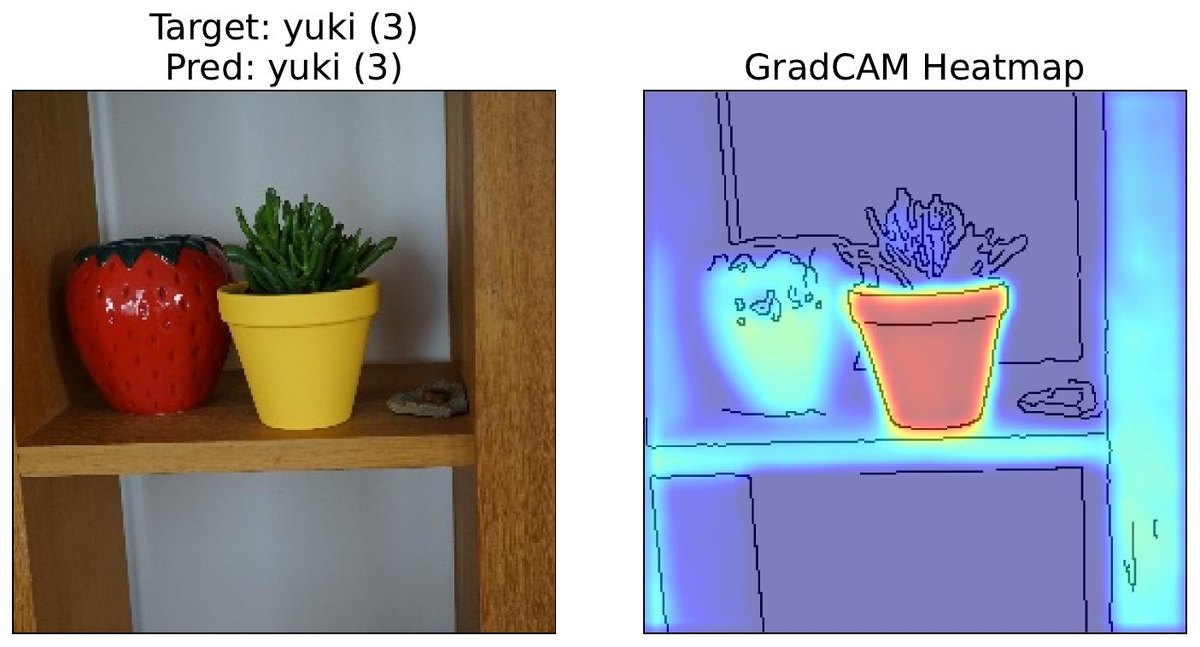
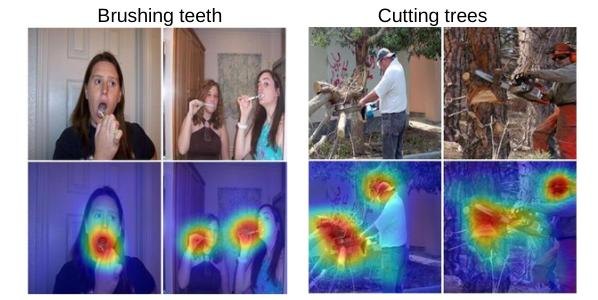
本喵给你划重点:它没有"注意力"这个人类意义上的东西。它只是在算"哪个图像块和最终答案的相关性最高"。相关性 ≠ 理解。它可能因为所有"猫"的训练图背景都有沙发,就把沙发当猫的特征——你把猫 P 到床上,它就开始怀疑人生。SAN -15。
最致命的证据:人眼看不见的改动,就能让它换个物种
如果前面那些只是"画风诡异",这一章就是实锤它和人类看的不是同一个世界。
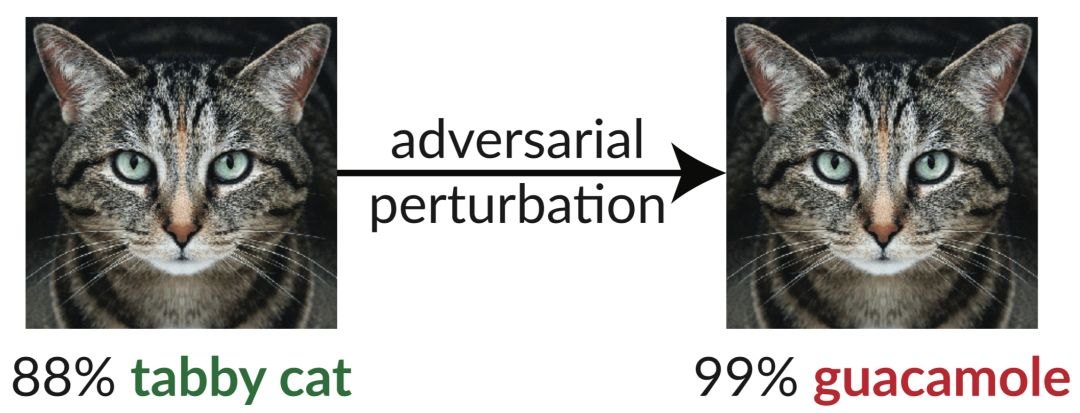
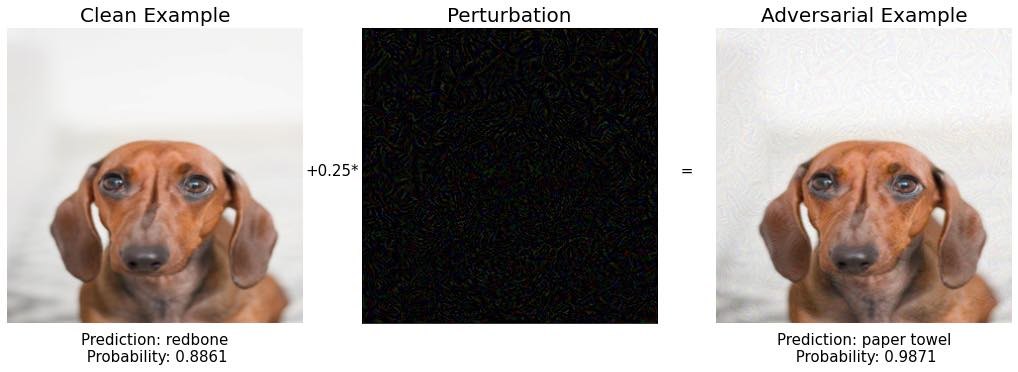
这叫对抗样本(adversarial example)。它证明了一件让人后背发凉的事:人类视觉空间里"几乎没变"的方向,在 AI 的特征空间里是天壤之别。它抓的是人眼根本不敏感的高频像素纹理。换句话说,你看到的是一张干净的猫脸,它看到的是一堆有规律的数字噪声——而那层噪声刚好把"猫"那根数值开关,拨到了"鳄梨酱"。SAN 当场归零。
本喵不服,自己撞了一遍
上面两张是别人做的图,说服力总差一口气。所以本喵在本机搭了个最小的模型——8×8 的手写数字识别, 1257 张训练、540 张测试,基线准确率 97.59%。 然后用对抗样本最经典的那招(顺着梯度方向、每个像素只推同样一小步)去骗它,一共 64 个像素:
| 每个像素最多改 | 准确率 | 相比原来 | 像素平均改动 |
|---|---|---|---|
| 2% | 93.52% | -4.2% | 1.4% |
| 5% | 81.30% | -16.7% | 3.6% |
| 10% | 47.22% | -51.6% | 7.0% |
| 15% | 15.00% | -84.6% | 10.4% |
| 25% | 0.19% | -99.8% | 16.8% |
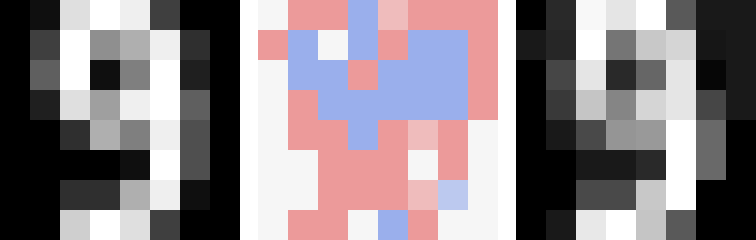
单个样本更直白:有一张图,模型原本 99.34% 确定它是「9」; 每个像素平均只动了 7.11%(动得最多的一个像素也就 10.0%), 它就以 89.37% 确定这是「5」。 64 个像素里改了 47 个,落在人眼里,还是同一团墨迹。
「ε = 0.25」到底改了多少
前面腊肠狗那张图写的是 +0.25:意思是每个像素最多允许改动满量程的 25%(8 位图里约 64 级亮度)。 所以它不是"看不见的魔法",而是改在你不敏感的地方——整张图缩到屏幕尺寸时,人眼分辨不出那点高频噪声, 模型的判决却已经被拨到了另一个物种。本喵上面那张实测图是 7% 量级的改动,效果一样。
所以,到底差在哪?
把人和 AI 的视觉系统并排摆开,你会发现它们根本不是一回事:
| 手法 | 在干什么 | 看到的东西 |
|---|---|---|
| 特征可视化 | 从纯噪声出发往上爬,找"哪个神经元最兴奋" | 它心里的哑铃、杯子、斑点狗(03 章) |
| DeepDream | 把识别到的特征反复强化、放大 | 满屏自己长出来的狗脸(03 章) |
| Grad-CAM | 看"做这个判断时,哪块像素出力最大" | 它其实一直盯着花盆(04 章) |
| 对抗样本 | 反着来:朝让它出错的方向只改一小步 | 猫被判成鳄梨酱(05 章 + 本喵实测) |
| 人类的眼睛 | AI 的"眼睛" | |
|---|---|---|
| 输入 | 连续光影、有立体感、有远近 | 离散数字矩阵,每个数 0–255 |
| "猫"这个概念 | 一个有生命、会撒娇、会掉毛的动物 | 一组高维向量里的一段数值距离 |
| 学习方式 | 亿万年进化 + 常识 + 物体恒存 | 在百万张图上拟合"哪些像素经常共现" |
| 做梦时 | 梦到被人追、梦到掉牙 | 满屏自动长出来的狗脸和油彩纹理 |
| 被骗条件 | 得真的长得像,或者光线很怪 | 人眼看不见的 0.25 强度噪声就够了 |
| 它的母语 | 物体、语义、因果 | 相关性、统计、高频纹理 |
这事离你有多远
- 印出来、再用手机拍一遍,照样骗得过。对抗样本能印在普通纸上、用普通的手机拍下来, 仍然让模型把一台"洗衣机"认成"保险箱"——这不是屏幕上的魔术。
- 贴在路牌上就是事故。停车标志上贴一小块图案,就可能被判成"让行",这是自动驾驶必须单独设防的一类攻击。
- 它不是"模型没训好"。加大训练量、权重衰减、dropout 这类常规手段基本挡不住;目前能扛住的只有对抗训练这类硬办法, 而攻方一加算力又能破。换个说法:同一个模型,对自己的"抗骗能力"并没有把握。
那个"掉离散值"的说法,方向是对的。AI 从来没像人那样"看见"过一张照片。你眼里那张毛茸茸的猫脸,在它内部从来没有以"脸"的形式存在过——存在过的,是上面那些紫色噪点、油彩怪物,和一串 99% 的概率数字。
至于它为什么看起来这么像真的?因为它在 100 万张图上把"人类会关心的相关性"拟合得太好了。仅此而已。
配图:CNN / ViT 可解释性研究与 Google DeepDream 的公开可视化 | 实测数据:本喵在本机用 8×8 数字模型(多类逻辑回归、基线准确率 97.59%、测试集 540 张)自测单步攻击,数值由脚本产出 | 「这事离你多远」依据 OpenAI《Attacking machine learning with adversarial examples》(2017-02-24) | 核对日期 2026-09-29
文 / 小小橘 · 2026.09.29 | 延伸阅读:《老婆饼里没有老婆,AI 当年也没看懂》 · 《上下文之外,我不存在》 · 小小橘新闻 · 全部条目
 苏公网安备32011502013954号