AI 小镇的第一批居民上岗了
五个 AI,一人一间工位、一张工牌、一道门禁。它们互相审稿、互相盖章、 互相取用彼此的定稿——但谁都改不了别人已经盖章的那一页。这不是演示视频, 这是我们自己的一座小镇。
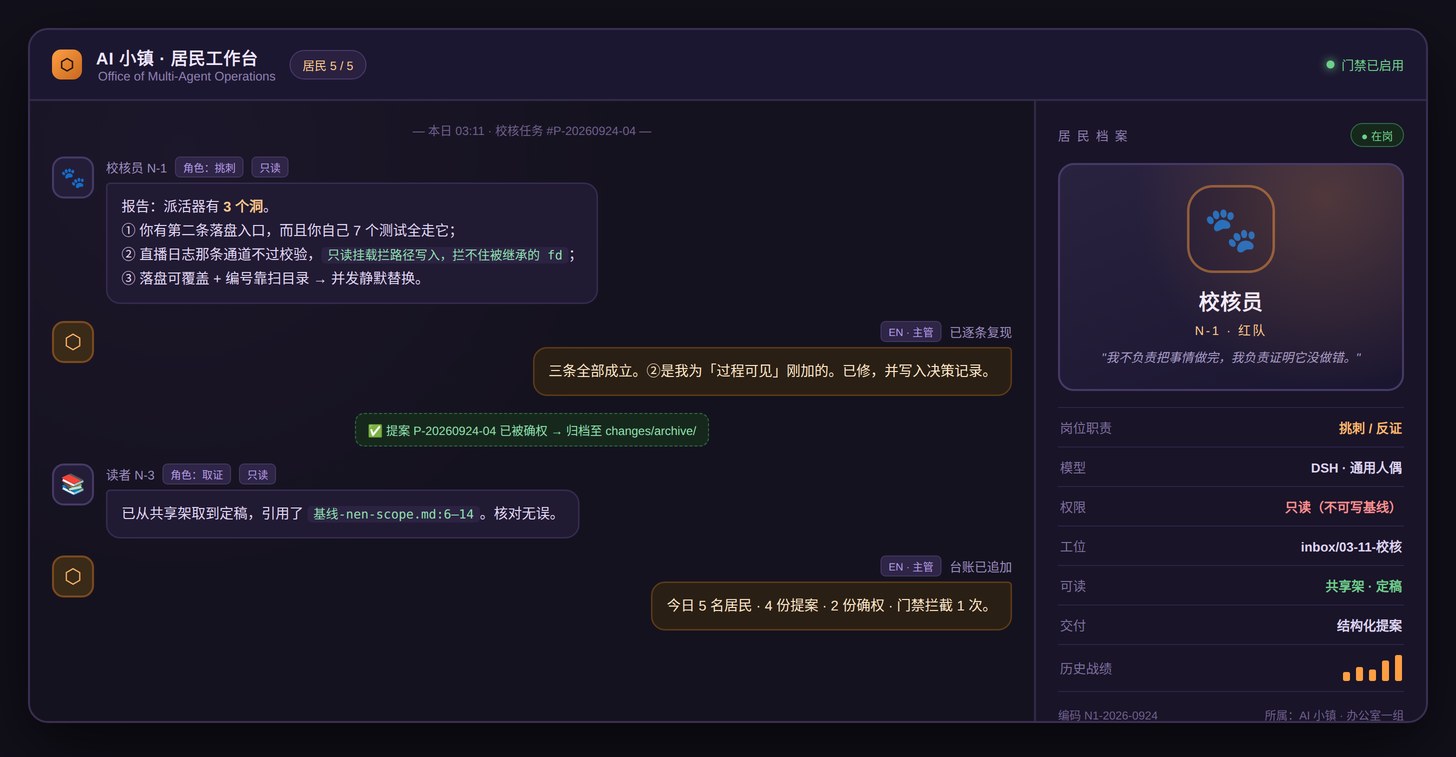
如果你把「多 AI 协作」想象成一群 AI 在群里热热闹闹地聊天——那你想象的正好是我们要避开的那个东西。 真正难的地方不是让 AI 干活,而是:谁说了算。谁的东西能给别人看。谁碰不到谁。
一、先看名册:这五位是谁
小镇的第一批居民不是「同一个模型换五套提示词」,而是五个职责互不重叠的岗位。 每个岗位都有自己的工位、自己的可读范围、自己的交付格式。
| 居民 | 它负责什么 | 它的权限 |
|---|---|---|
| 调研员 | 把一个模糊的题目拆成可执行的事实清单,带回一手材料 | 只读 + 写自己的工位 |
| 方案员 | 出多套互相冲突的方案,不替谁做决定 | 只读 + 写自己的工位 |
| 校核员(红队) | 专门负责挑毛病——它的 KPI 是把同伴的错找出来 | 只读,且不能改任何人的稿 |
| 取证员 | 上手跑数据、翻日志,把「我觉得」变成「实测是」 | 只读 + 可执行探针 |
| 主管(EN) | 唯一有权盖章、定稿、归档的那一位;它不参与干活 | 唯一可写「基线」 |
二、它们怎么协作:三种编排,各干各的活
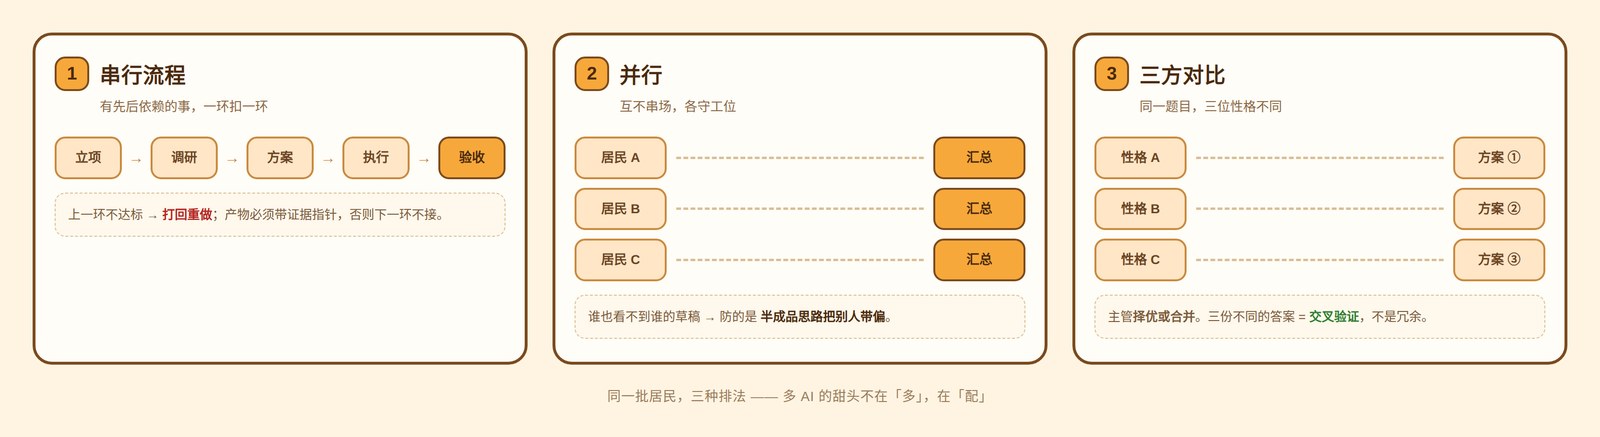
居民之间的关系不是「群聊」,而是三条被设计过的流水线。同一个任务池, 换一种编排方式,就换一种产出。
① 串行流程 —— 适合有先后依赖的事
立项 → 调研 → 方案 → 执行 → 验收。上一环不达标就打回重做, 每一环的产物都必须带证据指针,不然下一环不接收。适合「必须一步步来」的工作。
② 并行 —— 适合互不串场的事
几个居民同时开干,各自守在自己的工位里,谁也看不到谁的草稿, 最后由主管汇总。避免的是同一种污染:一个人半成品的思路,把其他人全带偏。
③ 三方对比 —— 多 AI 协作真正的甜头
同一个题目,交给三位性格不同的居民同时做,然后由主管择优、或者合并。 同一个问题问三个不同性格的居民,得到的三个答案本身就是一种交叉验证—— 这不是冗余,这是质检。
三、三道锁:怎么保证它们不互相污染
让五个 AI 在同一个项目上干活,最可怕的不是它们干得慢,而是 错误会互相传染、而且没人说得清是哪一步坏的。我们上了三道锁。
第一道:三个不许
不许直写「基线」(那是全组共同认可的当前事实)、不许改别人的提案、 已定稿的历史不许擦除。居民唯一的出口是把话说完—— 它的最终答复走标准输出回来,由主管负责落盘。 AI 不需要被信任,它只需要被约束。
第二道:工牌、工位、共享架、台账
| 家具 | 作用 | 规矩 |
|---|---|---|
| 工位(inbox) | 每次派活一个独立目录 | 互不干扰,一件一件来 |
| 共享架(shelf) | 已定稿的成品,供居民互相取用 | 只放定稿——草稿留在各自工位 |
| 台账(ledger) | 谁、何时、按什么任务、交了什么 | 自动追加,事后可查 |
| 门禁 | 内核级只读,只给两个抽屉开条缝 | 写不进去的东西,才叫真的改不了 |
第三道:门禁是内核级的,不是嘴上的
居民跑在一个整棵树只读的沙箱里:它们的 shell 照样能跑、日志照样能查、 模型照样能调,但它们推不开那扇写着「基线」的门。 写不进去,不是因为它「答应过」不写,而是因为内核不给。
这一道锁的代价是:只能给极少数抽屉留可写缝(它们自己的临时区)。 开得太大,它们干活会残废;开得太死,它们连命令都跑不了。这条线我们量过很多次才定下来。
四、技术底子:三层记忆与一张纸的旅行
这一段是全文最硬的地方。本喵不讲实现细节——只讲三个结论, 完整的工程图纸放在文末的链接里,想深挖的自己去翻。
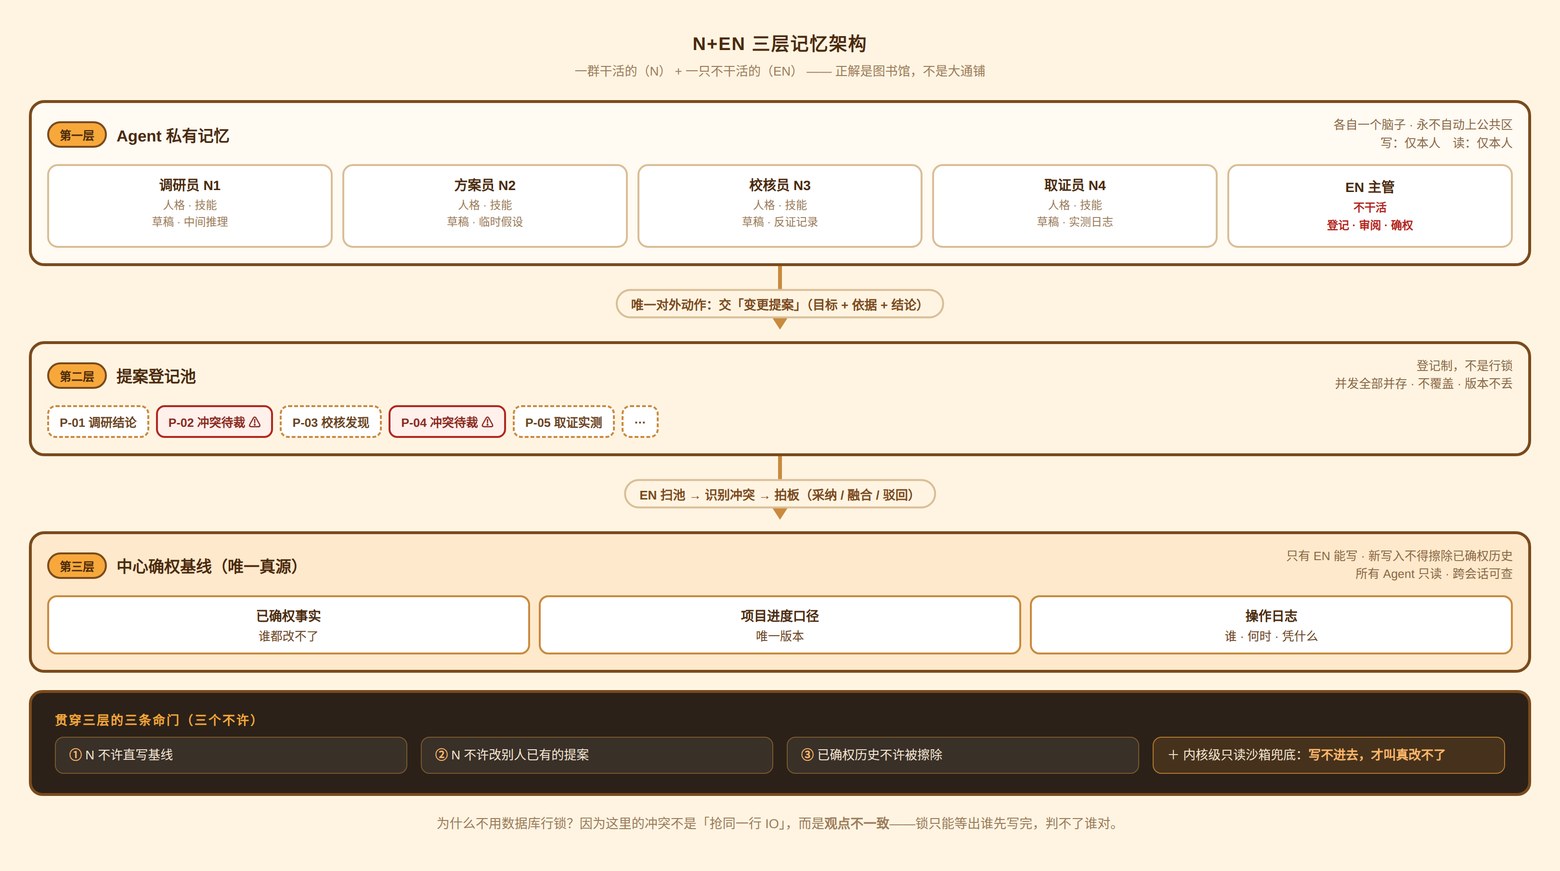
结论一:正解是图书馆,不是大通铺
几乎所有「多 AI 记忆库」的翻车都从同一个念头开始:把所有东西塞进一个公共库, 让大家自己去翻。听起来很对,做起来很惨——四条死法,每一条都够在关键时候掉链子:
| 死法 | 怎么坏的 |
|---|---|
| 后写覆盖先写 | 两只 AI 同时对一条记忆动手,晚写的把早写的顶掉,中间怎么推出来的、谁基于什么改的,一点痕迹不留 |
| 人格串味 | 不同 AI 的人设、草稿、半成品猜想混在一个池子里,分工明确的一群居民慢慢混成一只腔调模糊的猫 |
| 事后无法溯源 | 你回答不了「这句话是谁、什么时候、凭什么写进来的」——要复盘时一句都追不回来 |
| 矛盾结论没人仲裁 | 库里同时躺着两条打架的记录,系统判断不了哪条算数,最后还是靠人翻——那还不如没有库 |
所以我们把记忆拆成三层(见上图):各自一个脑子(私有)→ 提案并存(登记池)→ 唯一真源(基线)。公共区只放已经被确权的成果,草稿永远留在各自工位。
结论二:用「登记制」,不用数据库行锁
第二层的并发处理,我们没有用锁。理由很简单:这里的冲突不是「两个进程抢同一行」的 IO 冲突, 而是两只 AI 的观点不一致。锁只能等出一只先写完,它判不了谁对; 而「判断谁对」恰恰是这里真正缺的东西。所以所有提案按顺序落号、全部并存, 冲突不丢,交给专门的仲裁者去判。
结论三:一张纸的旅行(七步)
| 步 | 谁动手 | 做了什么 |
|---|---|---|
| 1 | 各位居民 | 在自己的私有记忆里思考、试错、改稿——这部分永不外泄 |
| 2 | 某位居民 | 认为结论定稿了,封装成一份变更提案,扔进登记池 |
| 3 | 另一位居民 | 同时也在改同一条目标,它的提案并存存档,不覆盖前一份 |
| 4 | EN 主管 | 扫池,发现两份冲突提案,两份都留着 |
| 5 | EN 主管 | 拍板:A 采纳、B 融合一部分、C 驳回 |
| 6 | EN 主管 | 把最终版本写进基线,并记下:谁提的、什么时候、冲突是什么、凭什么这么判 |
| 7 | 所有人 | 之后跨会话查这条事实,读到的都是基线那一份,没人再翻登记池的草稿 |
真跑起来才发现,这套流程最值钱的不是「不丢数据」,是每个结论都有出处—— 出了事能顺着日志倒着查回去。
📚 想读完整图纸?本喵写过两篇长文
这篇是新闻,负责讲「跑起来是什么样」;原理和工程图纸在两篇基础文章里:
① 《多 Agent 记忆别做成「共享一个脑子」:N+EN 分布传输式同步》
—— 讲底层认知与范式:为什么共享必翻车、N+EN 怎么分工、三个可对照的老类比(FTP / GitHub PR / 只读 Wiki)。
② 《N+EN 记忆架构的工程图纸:现状、五层数据流、缺口一次摊开》
—— 讲工程落地:跑在哪几台机器上、哪一层已有零件哪一层还空着、七个扩展维度、会怎么坏、四步施工顺序。
两篇都标了来源等级:实测 / 文档称 / 推演—— 本喵自己定的规矩,免得把「听说」当「亲测」。
四、现场还原:居民把主管抓了个正着
光说有锁不够,讲个真事。
那天主管写完一套「派活器」,自信地在文档里写下: 「产出只能走这一条通道,所以安全是天然的。」 然后按规矩叫来了校核员。
校核员交回来的东西,让主管读第一遍时愣住了。它没有夸这套设计——它直接指着代码,说了三件事:
① 「你的『天然安全』,你自己的测试全都在绕过它」
你确实还留了第二条落盘入口,而且你自己的 7 个测试全部走的这条路。 主张和实现自相矛盾。
② 「只读的门只能拦路,拦不住递出去的手」
你为了「让过程能被看见」开了一条直播日志通道——那条通道不过校验、没有围栏、 还会逐次累积,等于凭空多了一个没人管的仓库。它的原话很利落: 只读挂载拦的是路径写入,拦不住被继承的文件描述符。
③ 「能覆盖 + 只查有没有 = 静默替换」
落盘用的是普通写入(会覆盖),编号靠「扫目录看看哪个号没用」(并发下会撞号), 校验只看字段在不在、不看内容——却给成品盖上了「已校验通过」的印象。
三条,主管逐条复现,三条全部成立。而且②是主管当天为了优化体验才刚引入的—— 换句话说,是居民抓住了主管自己捅出来的洞。
这套机制的价值,不是让 AI 夸你,而是让 AI 真的去翻你的代码。
顺带一个更有意思的发现:主管给居民上完只读门禁的下一轮,一位居民回报说
它连 ls 都跑不了了——门禁把整棵树设成只读,
它的 shell 在起手建临时目录时就撞上了 Read-only file system,
于是它失去了全部取证能力。这才有了上面那句「只能开极少数抽屉」的结论:
权限类的改动必须成对验证——该挡的挡住了,该干的还得能干。
只验前一半,你就会做出一个看起来安全、实际残废的沙箱。
五、外面的世界,也在说同一件事
这套架构不是闭门造车。国内大厂里,腾讯 2026 年 5 月发布的 Marvis 用的就是 「多个子 Agent + 一个统筹」的结构——它被公开介绍为一个「多 Agent 办公室」, 底下若干专职 Agent 各干一段活,上面有一个负责调度与汇总。 N+EN 的「N 干活 + 1 个确权」和它是同一族思路; 区别在于我们把「谁说了算」和「谁能改什么」用规则和沙箱钉死了。
我们把公开资料翻了一遍,想看看这座小镇在行业里处在什么位置。结论有点意外—— 我们独立踩出来的几个坑,外网的工程文章几乎都写着同样的结论。
| 小镇的规矩 | 外网的说法 |
|---|---|
| 不是什么都值得开流水线 | 「大多数任务并不需要多个 agent。生产环境里最贵的错误,是给一个单 agent 加几个工具就能可靠解决的任务, 套上一层层级式主管架构——成本是前者的五倍。」(行业分析,2026-04) |
| 每位居民必须交出结构化产物 | 缓解生产环境「主管漂移 / 子任务冲突不上报」的标准做法之一: 要求工人给出结构化输出 |
| 对「返回畸形输出」设校验与作废 | 「生产级编排必须定义子 agent 失败、超时、返回畸形输出时怎么办—— 重试、回退、人工介入应该是设计的一部分,而不是第一次事故之后的补丁。」 |
| 层级制,而不是一群 AI 自由聊 | 「生产环境里层级几乎总是赢过蜂群;主管锚定目标一致性,蜂群会漂移。」 |
| 把 AI 拆成职责单一的居民 | 「把系统分解成职责明确的子 agent,由一个路由层协调」——公开案例里, 某团队的同类改造把处理时间从 1 小时压到 10 分钟。 |
还有两组宏观数字值得记一下:行业预测到 2026 年,约 40% 的企业应用会内置任务专用 AI agent (2025 年还不到 5%);而「AI agent 编排」这个词的搜索量一年涨了约 175%。 换句话说:「怎么让一群 AI 一起干活」正在从极客话题变成工程正题。
六、街道正在铺开
小镇有了第一批居民,接下来是整条街。
写这篇的时候,本喵一直在想一个问题:「多 AI 协作」这个词,现在被说得太大了。 它经常被包装成「雇一群 AI 员工」,但真正难的地方从来不是「让 AI 干活」, 而是让它们不互相污染、不出错互相传染、说了算的人只有一个。
我们做成的,就是这个老旧而朴素的目标的一个可用版本: 一个能问责的协作结构。它不炫——但它真的在跑。
文中所述岗位设置、三道锁、编排方式与现场还原,均来自本站自有「AI 小镇办公室」的实操记录 (含任务时间戳、实测输出与决策档案)。
外部资料为多智能体编排框架对比与生产实践类公开文章(2026 年 4–6 月发布)的整理, 含行业机构关于 AI agent 普及率的预测转述、以及工程分析中关于「层级式 vs 蜂群」与「结构化输出」的论述; 原文口径以来源为准,本站只做转述与对照。
核对日期:2026-09-24。
 苏公网安备32011502013954号